Latencia, errores y saturación: 3 señales de alerta antes de una caída
Cómo detectar problemas antes de que afecten al servicio
Una caída de un servicio rara vez aparece sin previo aviso. En muchos casos, la infraestructura empieza a mostrar señales de que algo no funciona correctamente: las aplicaciones tardan más en responder, aumentan los errores o los recursos disponibles comienzan a quedarse cortos.
El problema es que estas señales no siempre se interpretan a tiempo. Detectarlas y entender qué las provoca permite anticiparse a fallos mayores y reducir su impacto.
Hay tres indicadores especialmente útiles para ello: latencia, errores y saturación.
1. Latencia: cuando los servicios empiezan a responder más lento
La latencia es el tiempo que tarda un sistema en responder a una petición. Cuando aumenta, los usuarios pueden notar que una página tarda en cargar, una operación se demora o una aplicación responde con lentitud.
Un incremento puntual no siempre indica un problema grave. Sin embargo, si los tiempos de respuesta crecen de forma continuada, puede ser una señal de que algo está afectando al rendimiento.
Entre sus posibles causas están:
- Sobrecarga de los servidores.
- Consultas a bases de datos demasiado lentas.
- Problemas de comunicación entre servicios.
- Recursos insuficientes para atender las peticiones.
Por ejemplo, si una tienda online empieza a tardar varios segundos más en mostrar sus productos, puede estar experimentando un problema de rendimiento que, si no se identifica, podría terminar afectando al proceso de compra y, sin duda alguna, a la experiencia del cliente.
2. Errores: cuando las operaciones empiezan a fallar
El aumento de errores es otra señal importante. Puede manifestarse mediante peticiones que no se completan, respuestas fallidas o funcionalidades que dejan de estar disponibles.
No todos los errores tienen el mismo origen ni las mismas consecuencias. Algunos son puntuales, mientras que otros pueden indicar un problema que afecta a distintos componentes de la infraestructura.
Conviene prestar atención a situaciones como:
- Aumento de respuestas HTTP 5xx.
- Fallos recurrentes en las peticiones.
- Errores de conexión entre servicios.
- Operaciones que no llegan a completarse.
Por ejemplo, si una aplicación empieza a registrar errores al consultar una base de datos, otras funcionalidades que dependen de ella también pueden verse afectadas.
Analizar los errores y relacionarlos con otros indicadores ayuda a encontrar su origen antes de que el problema se extienda.
3. Saturación: cuando los recursos se acercan a su límite
La saturación aparece cuando los recursos de un sistema se utilizan hasta el punto de dificultar su funcionamiento normal.
Puede afectar a la CPU, la memoria, el almacenamiento o la capacidad de gestionar peticiones. Cuando un recurso se acerca a su límite, el sistema puede empezar a responder más lentamente o a generar errores.
Algunas señales habituales son:
- Uso elevado y sostenido de CPU.
- Memoria disponible cada vez más limitada.
- Incremento de las colas de peticiones.
- Recursos de almacenamiento próximos a su capacidad.
Imaginemos que una aplicación recibe un aumento de tráfico. Si sus servidores no pueden procesar todas las peticiones, empezarán a acumularse solicitudes y los tiempos de respuesta aumentarán.
Por eso, detectar la saturación antes de alcanzar el límite de capacidad permite actuar con antelación.
¿Por qué es importante analizar las tres señales juntas?
La latencia, los errores y la saturación no deben analizarse siempre por separado. En muchas ocasiones, están relacionadas y forman parte de un mismo problema.
Por ejemplo, un servidor puede empezar a utilizar demasiada CPU. Como consecuencia, aumenta el tiempo de respuesta y algunas peticiones terminan fallando.
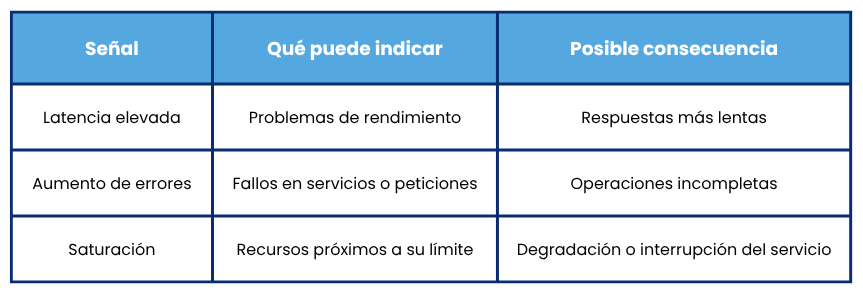
Relacionar estas señales permite comprender mejor qué está ocurriendo y distinguir un síntoma aislado de un problema que puede acabar provocando una caída.
¿Cómo ayuda Korai a anticiparse a los problemas?
Korai, la plataforma de observabilidad e inteligencia artificial de Lessthan3, permite reunir métricas, logs, trazas y eventos para ofrecer una visión conectada del comportamiento de la infraestructura.
Sus capacidades ayudan a detectar anomalías, correlacionar señales y comprender cómo se relacionan los distintos componentes de un entorno cloud.
Anticiparse es mejor que reaccionar
Una caída puede ser el resultado de varios problemas que han ido apareciendo progresivamente. Por eso, vigilar la latencia, los errores y la saturación es fundamental para conocer el estado real de una infraestructura.
Detectar las primeras señales, relacionarlas y entender su origen permite tomar decisiones antes de que el impacto llegue a los usuarios e impacte al negocio.
Con Korai, los equipos disponen de más contexto para comprender lo que sucede en su infraestructura y pasar de reaccionar ante las caídas a anticiparse a los problemas.