¿Por qué tu aplicación va lenta? 6 causas que una infraestructura compleja puede esconder
Descubre qué puede estar detrás de una aplicación lenta
Que una aplicación vaya lenta parece, a priori, un problema sencillo de identificar. Por ejemplo, cuando un usuario nota que una página tarda demasiado en cargar, una petición a un sistema responde con retraso o un proceso que antes funcionaba en segundos ahora necesita mucho más tiempo.
Pero en las infraestructuras cloud modernas, encontrar el origen de esa lentitud puede ser mucho más complicado.
Una aplicación puede depender de decenas de servicios, APIs, bases de datos, contenedores o proveedores externos. Una sola petición puede recorrer muchos componentes antes de llegar al usuario.
Por eso, cuando aparece un problema de rendimiento, el componente donde vemos dicho problema no tiene por qué ser el que lo está provocando.
La clave está en entender qué ocurre en todo el recorrido de una petición o cómo interactúan aplicaciones y servicios.
1. Recursos insuficientes o mal dimensionados
CPU, memoria, almacenamiento o capacidad de red pueden convertirse en cuellos de botella cuando aumenta el tráfico o cambia el comportamiento de los usuarios.
Pero no se trata simplemente de añadir más capacidad. También puede ocurrir que existan recursos suficientes y el problema esté en otro punto.
Entender cómo se están utilizando los recursos y qué componente está limitando el rendimiento es el primer paso.
2. Una base de datos que se ha convertido en el cuello de botella
Una aplicación puede funcionar correctamente y, aún así, ofrecer una experiencia lenta porque las consultas a la base de datos están tardando demasiado.
Consultas poco eficientes, un aumento del volumen de datos o la saturación de conexiones pueden terminar afectando al rendimiento de toda la aplicación.
Desde fuera todo puede parecer simplemente que “la aplicación va lenta”, cuando el origen está en otro componente.
3. Una API o servicio externo responde demasiado tarde
Las aplicaciones dependen cada vez más de otros servicios externos: pagos, autenticación, APIs, proveedores cloud o diferentes servicios especializados.
Si uno de ellos empieza a responder más lentamente, el retraso puede terminar trasladándose a toda la experiencia del usuario.
Por eso es importante tener visibilidad sobre las dependencias y poder distinguir rápidamente entre un problema interno y uno externo.
4. Un cambio reciente ha alterado el comportamiento del sistema
No todos los problemas de rendimiento aparecen porque algo se haya roto.
Un nuevo despliegue, una modificación de configuración, una actualización o un cambio en la arquitectura pueden alterar el comportamiento de un servicio.
Una pregunta clave cuando aparece una degradación es:
¿Qué ha cambiado justo antes de que empezara el problema?
Relacionar cambios con métricas, logs y trazas puede ayudar a encontrar conexiones que pasarían desapercibidas si cada información se analiza por separado.
5. El sistema está escalando, pero no donde debería
El escalado automático es una de las grandes ventajas del cloud, pero aumentar recursos no siempre resuelve un problema de rendimiento.
Imagina que un servicio recibe un aumento repentino de tráfico y comienza a escalar. La capacidad disponible aumenta, pero otro componente del sistema no puede asumir esa carga adicional.
El resultado puede ser una cadena de problemas:
más tráfico → más recursos → más peticiones → mayor saturación en otro componente → peor rendimiento.
Por eso, es importante analizar el comportamiento de toda la infraestructura, no únicamente del servicio que está escalando.
6. El problema no está en un único componente
Esta es una de las situaciones más difíciles de diagnosticar.
En una infraestructura distribuida, una aplicación lenta puede ser el resultado de varios pequeños problemas que ocurren al mismo tiempo.
Por ejemplo:
Una API empieza a responder más lento, aumentan las conexiones, una base de datos comienza a saturarse y aparecen errores.
Analizados por separado, estos eventos pueden parecer independientes.
Relacionados, pueden explicar exactamente qué está ocurriendo.
¿Qué señales pueden indicar que algo no va bien?
Cuando una aplicación pierde rendimiento, algunas señales pueden ayudar a localizar dónde empezar a buscar.
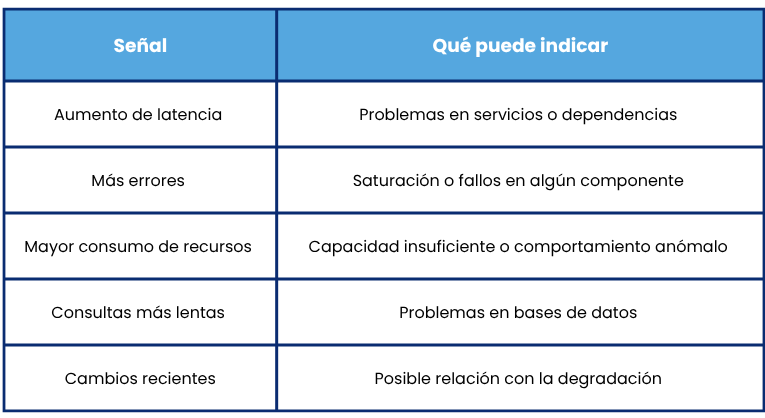
Pero analizar cada señal por separado no siempre es suficiente.
Lo importante es entender cómo se relacionan entre ellas.
La observabilidad ayuda a encontrar el origen
La observabilidad avanzada permite reunir métricas, logs y trazas para construir una visión más completa del sistema.
Las métricas muestran qué está cambiando, los logs aportan información sobre los eventos y las trazas permiten seguir el recorrido de una petición entre diferentes servicios.
Al conectar toda esta información, es posible pasar de:
“La aplicación está lenta.” a entender qué componente está provocando el retraso y cómo está afectando al resto del sistema.
¿Y qué aporta la inteligencia artificial?
Cuando las infraestructuras generan millones de datos, analizarlos manualmente deja de ser una opción eficiente.
La inteligencia artificial aplicada a la observabilidad permite analizar grandes volúmenes de información continuamente para detectar patrones, anomalías y relaciones entre diferentes eventos.
Por ejemplo, puede ayudar a identificar que una degradación comenzó después de un cambio o que varias alertas aparentemente independientes forman parte de una misma incidencia.
El objetivo no es tener más datos, sino entenderlos antes.
Cómo ayuda Lessthan3
En Lessthan3, ayudamos a las empresas a entender qué está ocurriendo realmente dentro de sus infraestructuras cloud.
Nuestra plataforma reúne métricas, logs, trazas y eventos en un mismo entorno y utiliza observabilidad e inteligencia artificial para detectar anomalías, correlacionar información y facilitar la identificación del origen de los problemas.
Así, los equipos pueden pasar de analizar señales aisladas a tener una visión completa del comportamiento de sus sistemas y control sobre los mismos.
Porque cuando una aplicación va lenta, saber que existe un problema es solo el principio. La clave está en entender por qué para resolverlo eficientemente.