Incidencias: cómo medir su impacto
Cómo identificar la gravedad de un problema y priorizar su resolución
En una infraestructura cloud, no todos los problemas tienen las mismas consecuencias. Una aplicación puede responder más lentamente de lo habitual, mientras que un fallo en un servicio crítico puede interrumpir la actividad de una empresa, e impedirle continuar con su actividad y,o ingresar dinero.
En ambos casos existe una incidencia, pero su impacto y la urgencia de resolver son muy diferentes.
Por eso, detectar un problema es solo el primer paso: también hay que entender sus consecuencias y decidir qué atender primero.
¿Qué es una incidencia?
Una incidencia es cualquier problema que interrumpe, degrada o impide el funcionamiento esperado de un servicio, una aplicación o un componente de la infraestructura.
Puede tratarse de una caída completa, un aumento de errores, tiempos de respuesta más lentos o un servicio que empieza a funcionar de forma irregular.
No todas las incidencias provocan una interrupción visible. Algunas degradan el rendimiento progresivamente y afectan a los usuarios antes de que el equipo técnico detecte su origen.
¿Qué determina el impacto de una incidencia?
La gravedad de un problema depende del servicio afectado, el número de usuarios perjudicados y las consecuencias para el negocio en términos económicos o de reputación.
Por ejemplo, una lentitud puntual en una herramienta interna no tiene el mismo impacto que un fallo en el sistema de pagos de una tienda online.
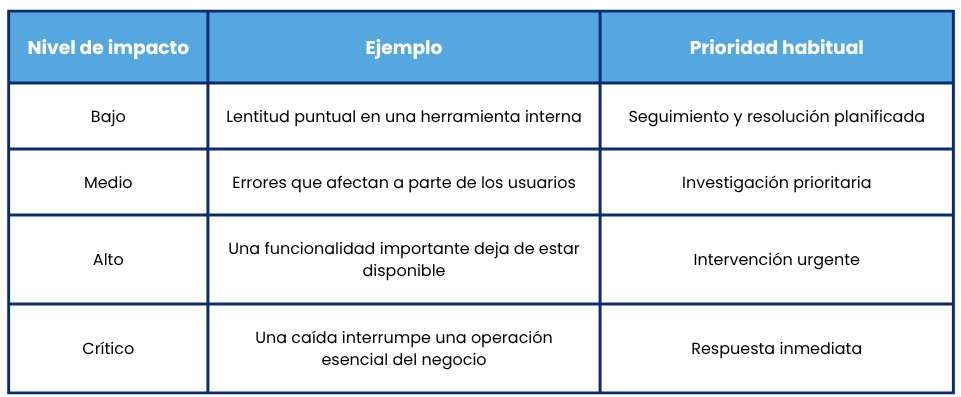
Esta clasificación es orientativa: cada organización debe establecer sus propios criterios según sus servicios y necesidades.
La prioridad no debería depender únicamente de la alerta recibida, sino de las consecuencias reales del problema.
El reto de distinguir lo urgente de lo importante
En entornos cloud complejos, una sola incidencia puede generar numerosas alertas. Un servicio empieza a responder lentamente, aumentan los tiempos de espera y otros componentes comienzan a fallar.
Sin contexto, estas señales pueden parecer problemas independientes y dificultar la identificación de lo que requiere atención inmediata.
Por eso, relacionar alertas y analizar distintas fuentes de información es fundamental para priorizar correctamente. Las métricas muestran cómo se comporta la infraestructura; los logs aportan detalles sobre los errores; y las trazas permiten seguir el recorrido de las peticiones entre servicios.
¿Cómo ayuda Lessthan3 a gestionar las incidencias?
La plataforma de Lessthan3 reúne métricas, logs y trazas en un mismo entorno para ofrecer una visión completa de lo que ocurre en la nube.
Gracias a sus capacidades de observabilidad e inteligencia artificial, permite detectar anomalías, correlacionar señales y comprender mejor el comportamiento de los servicios. Además, la funcionalidad de Trace Explainer ayuda a interpretar lo ocurrido y entender el impacto operativo, mientras que Troubleshooter ofrece recomendaciones para orientar la resolución.
Así, los equipos pueden pasar de recibir alertas aisladas a disponer de más contexto para decidir dónde actuar primero, reducir el tiempo de investigación y evitar que los problemas se agraven.
Resolver mejor empieza por priorizar
No todas las incidencias requieren la misma respuesta. Algunas pueden esperar; otras necesitan intervención inmediata para evitar que el impacto aumente.
Conocer qué está fallando, a quién afecta y qué consecuencias puede tener es fundamental para tomar mejores decisiones.
Con Lessthan3, los equipos disponen de una visión más conectada de su infraestructura para entender las incidencias y centrar sus esfuerzos en los problemas que realmente importan.