Causa raíz: qué es y por qué encontrarla rápido
Descubre cómo identificar el origen de una incidencia y acelerar su resolución
Cuando una aplicación falla o empieza a funcionar peor, lo primero que suele aparecer son las consecuencias: errores, aumento de la latencia, peticiones que tardan más de lo habitual o usuarios que no pueden completar una acción.
Pero esos síntomas no siempre indican dónde está realmente el problema.
En una infraestructura cloud moderna, una incidencia puede involucrar múltiples servicios. Por eso, detectar que algo está fallando es solo el primer paso. La verdadera dificultad está en encontrar qué lo está provocando.
Ahí es donde entra en juego la causa raíz.
¿Qué es la causa raíz de una incidencia?
La causa raíz (root cause) es el origen de un problema que desencadena una serie de eventos o errores dentro de un sistema o software.
No siempre coincide con el primer síntoma que detectamos.
Por ejemplo, una aplicación puede empezar a responder lentamente y generar cientos de alertas. A simple vista, podríamos pensar que el problema está en el servicio que presenta mayor latencia.
Sin embargo, al analizar el recorrido completo de una petición, podemos descubrir que el origen está en una dependencia concreta, una consulta a una base de datos, un cambio reciente o un servicio que está provocando una reacción en cadena.
Por eso es importante diferenciar entre:
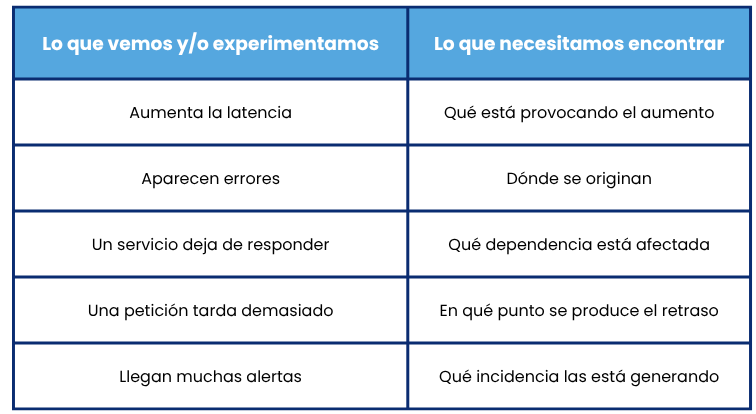
La diferencia está en pasar del síntoma al origen.
El problema de investigar una incidencia manualmente
Durante una incidencia, cada minuto cuenta.
El problema es que, en arquitecturas distribuidas, encontrar la causa raíz puede requerir revisar diferentes dashboards, logs, métricas y trazas, cruzar información entre herramientas y reconstruir manualmente qué ocurrió.
Mientras tanto, el impacto puede seguir creciendo.
Cuando toda esta información está separada, el diagnóstico puede convertirse en un proceso largo y complejo.
Las trazas permiten seguir el problema hasta su origen
Aquí es donde las trazas adquieren especial importancia.
Una traza permite seguir el recorrido de una petición a través de los diferentes servicios que intervienen en ella. En lugar de analizar cada componente de forma aislada, permite entender qué ocurre durante todo el recorrido.
Esto resulta especialmente útil cuando una aplicación depende de múltiples microservicios, APIs o sistemas externos.
Por ejemplo, una petición puede seguir este recorrido:
Usuario → API → servicio de autenticación → microservicio → base de datos → servicio externo
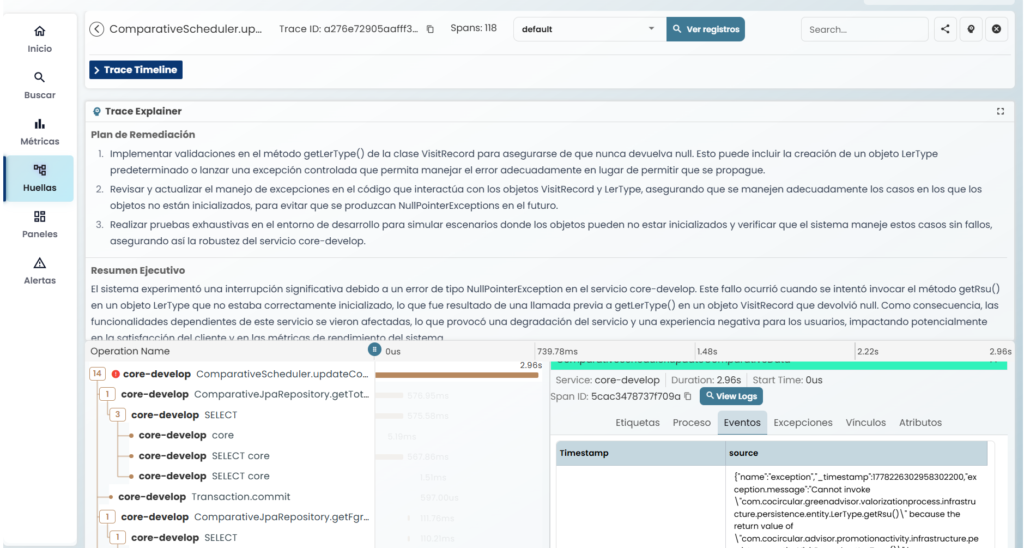
Si la respuesta tarda 5 segundos, saber que la aplicación tarda 5 segundos no explica el problema.
La traza permite identificar en qué punto se concentran esos 5 segundos y qué componente puede estar detrás de la degradación.
Y cuanto más compleja es la arquitectura, más valor tiene poder visualizar ese recorrido.
De analizar una traza durante horas a entenderla en segundos
La observabilidad proporciona los datos necesarios para investigar una incidencia, pero la cantidad de información que generan los sistemas actuales hace que analizarla manualmente siga siendo un reto.
Aquí es donde la inteligencia artificial aplicada a las trazas puede cambiar el proceso.
En Lessthan3, nuestra funcionalidad Trace Explainer utiliza IA para analizar una traza y explicar de forma sencilla qué está ocurriendo.
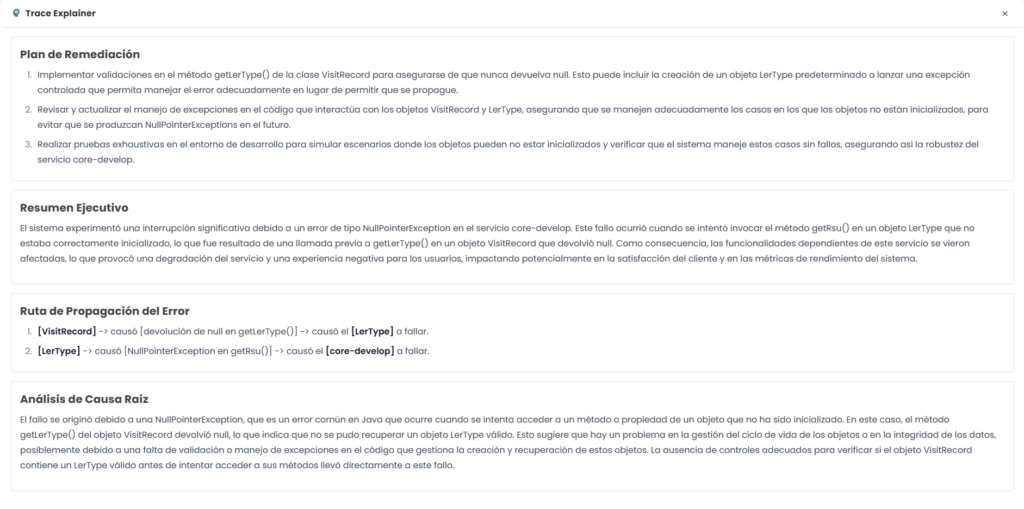
En lugar de obligar al equipo a revisar cada elemento de la traza manualmente, Trace Explainer identifica el origen del problema, resume lo ocurrido y proporciona contexto para entender qué está pasando.
El objetivo es sencillo: reducir el tiempo que los equipos necesitan para pasar de una traza a una explicación útil en lenguaje natural.
Un ejemplo práctico
Imagina un e-commerce en el que algunos usuarios empiezan a experimentar problemas durante el proceso de compra.
Las métricas muestran un aumento de la latencia y aparecen errores en diferentes servicios. A partir de ahí, el equipo podría comenzar a revisar logs, dashboards y alertas para intentar encontrar el origen.
Pero una única incidencia puede generar muchas señales diferentes.
Con observabilidad y trazas, el equipo puede seguir el recorrido de las peticiones afectadas y localizar dónde empieza la degradación.
Y con Trace Explainer, la IA puede analizar esa traza y ofrecer un resumen del problema, ayudando a identificar rápidamente la causa raíz y proporcionando información sobre qué revisar.
Lo que antes podía requerir horas de investigación manual puede convertirse en una explicación disponible en segundos.
Causa raíz ≠ primera alerta
Una de las ideas más importantes cuando hablamos de observabilidad es que la primera alerta no tiene por qué ser la causa del problema.
Una incidencia puede provocar una cadena de eventos:
Un servicio se degrada → aumenta la latencia → aparecen errores → otras dependencias empiezan a fallar → se generan múltiples alertas.
Si analizamos únicamente las alertas finales, podemos terminar investigando las consecuencias en lugar del origen.
La observabilidad permite conectar esas señales y las trazas ayudan a reconstruir el recorrido de una petición.
La IA añade una capa más: ayudar a interpretar toda esa información y convertirla en contexto accionable.
Menos tiempo investigando, más tiempo resolviendo
Encontrar la causa raíz rápidamente no solo mejora el diagnóstico. También cambia la forma en la que trabajan los equipos.
Un proceso de resolución más rápido puede ayudar a:
- Reducir el MTTR.
- Disminuir el tiempo dedicado a investigar manualmente.
- Evitar que los equipos trabajen sobre hipótesis incorrectas.
- Entender mejor el impacto de una incidencia.
- Tomar decisiones con mayor contexto.
- Resolver problemas antes de que su impacto aumente.
La cuestión no es simplemente detectar antes una incidencia.
Es entender antes qué está ocurriendo para poder actuar mejor.
Cómo ayuda Lessthan3 a encontrar la causa raíz
Encontrar la causa raíz de una incidencia requiere conectar diferentes señales y entender qué está ocurriendo dentro de la infraestructura. La plataforma de Lessthan3 reúne métricas, logs, eventos y trazas en un mismo entorno de observabilidad para facilitar ese análisis.
En el caso de las trazas, Trace Explainer utiliza inteligencia artificial para analizar lo ocurrido y explicar el origen del problema en segundos. En lugar de revisar manualmente cada paso de una traza, los equipos pueden obtener un resumen de lo sucedido, identificar dónde se encuentra el problema y saber qué aspectos deberían revisar.
Esto permite pasar de una investigación basada en datos dispersos a una visión más clara de la incidencia, reduciendo el tiempo dedicado al diagnóstico y facilitando una respuesta más rápida.
Encontrar antes la causa raíz no solo permite resolver una incidencia más rápido, también ayuda a los equipos a entender mejor lo que ocurre en su infraestructura y tomar decisiones con mayor contexto.